

Vision-Language Pretraining Enhanced Audio-Visual Multimodal Representation and Fusion Framework
-
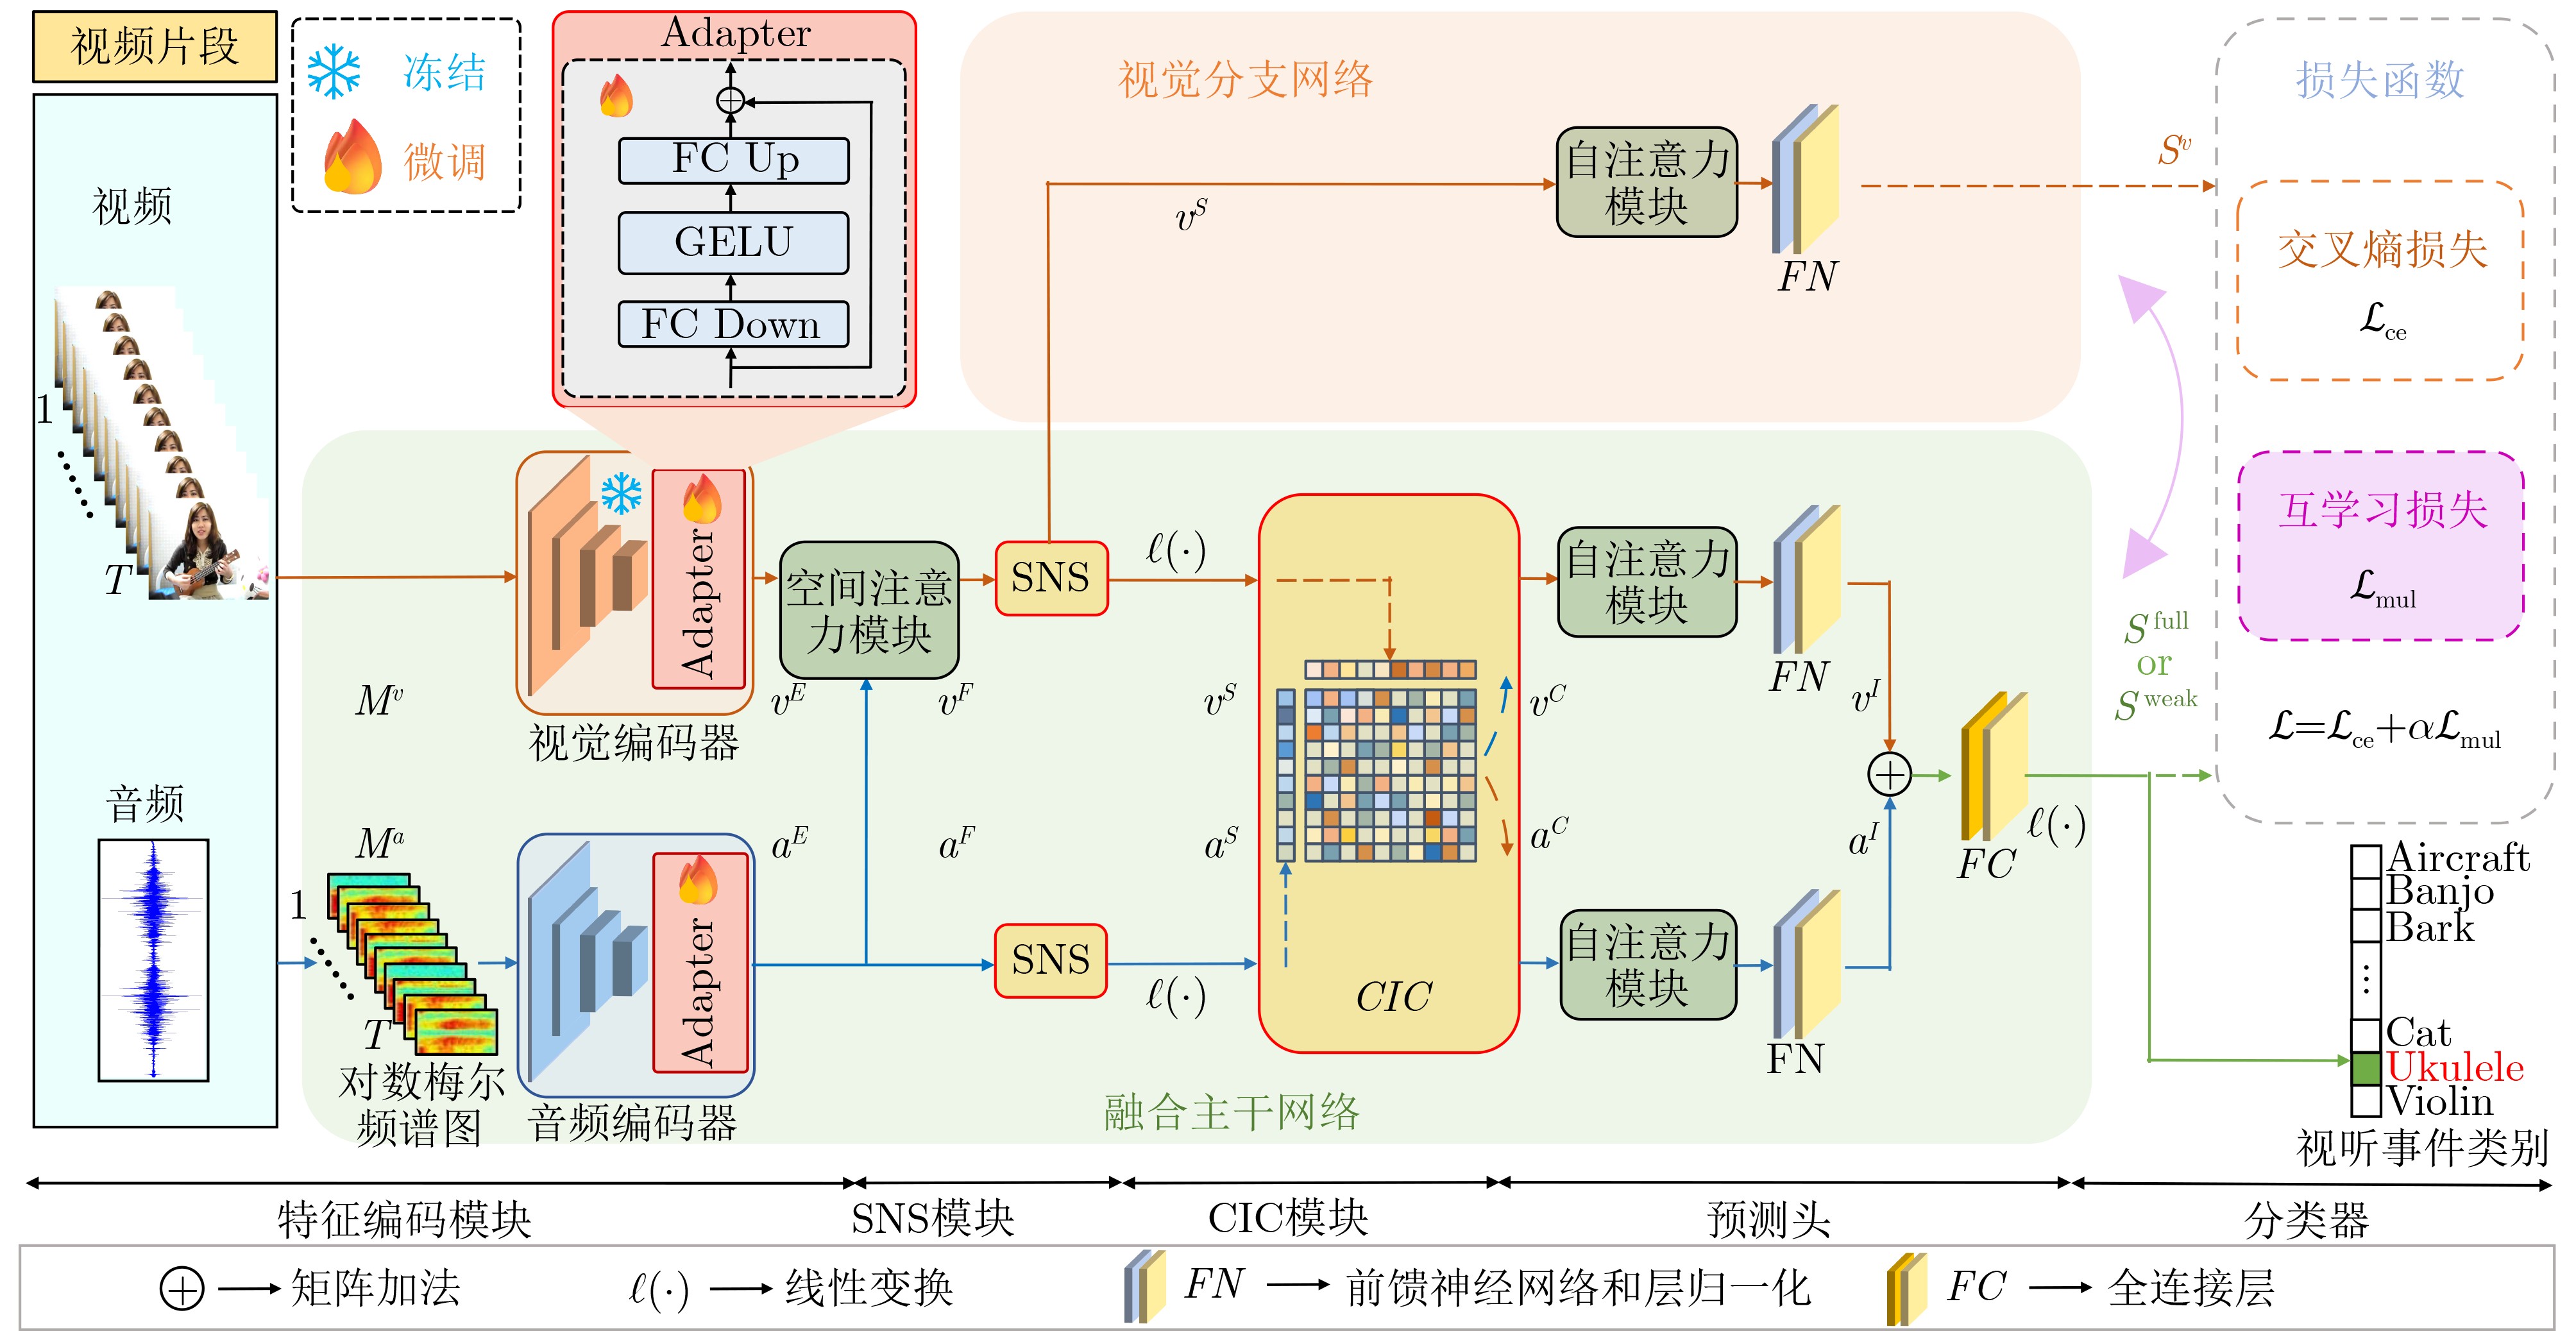
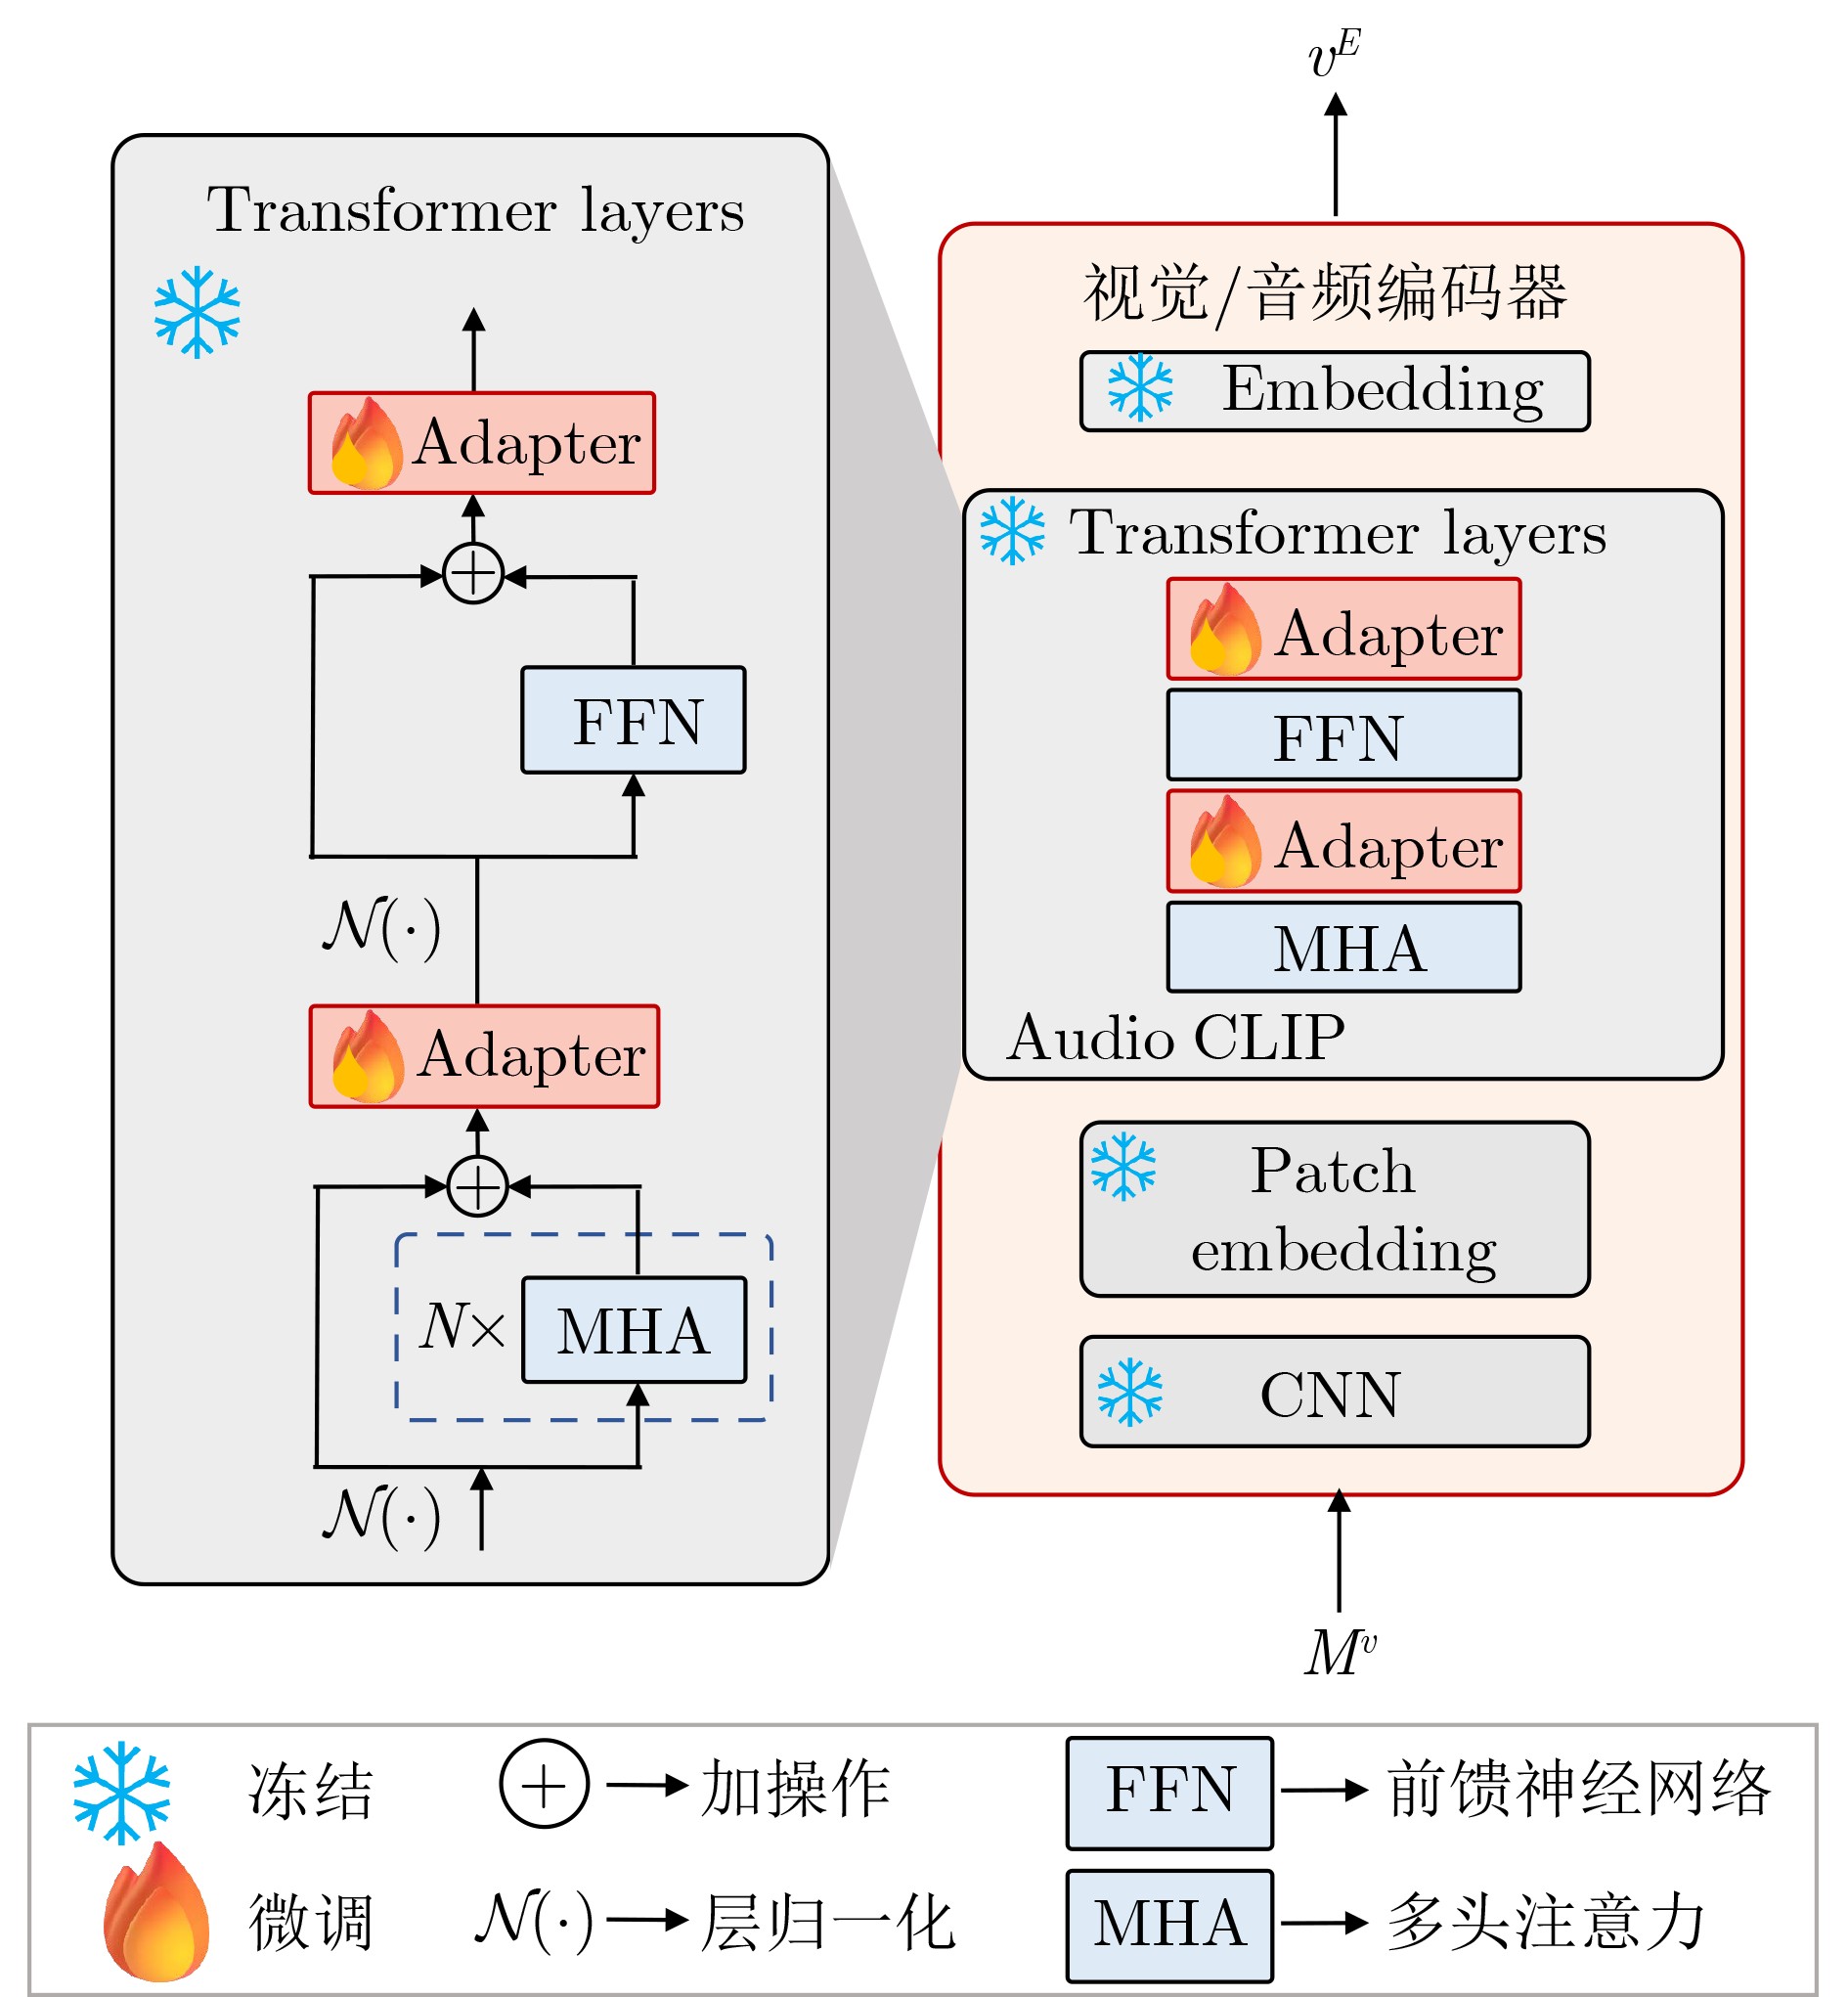
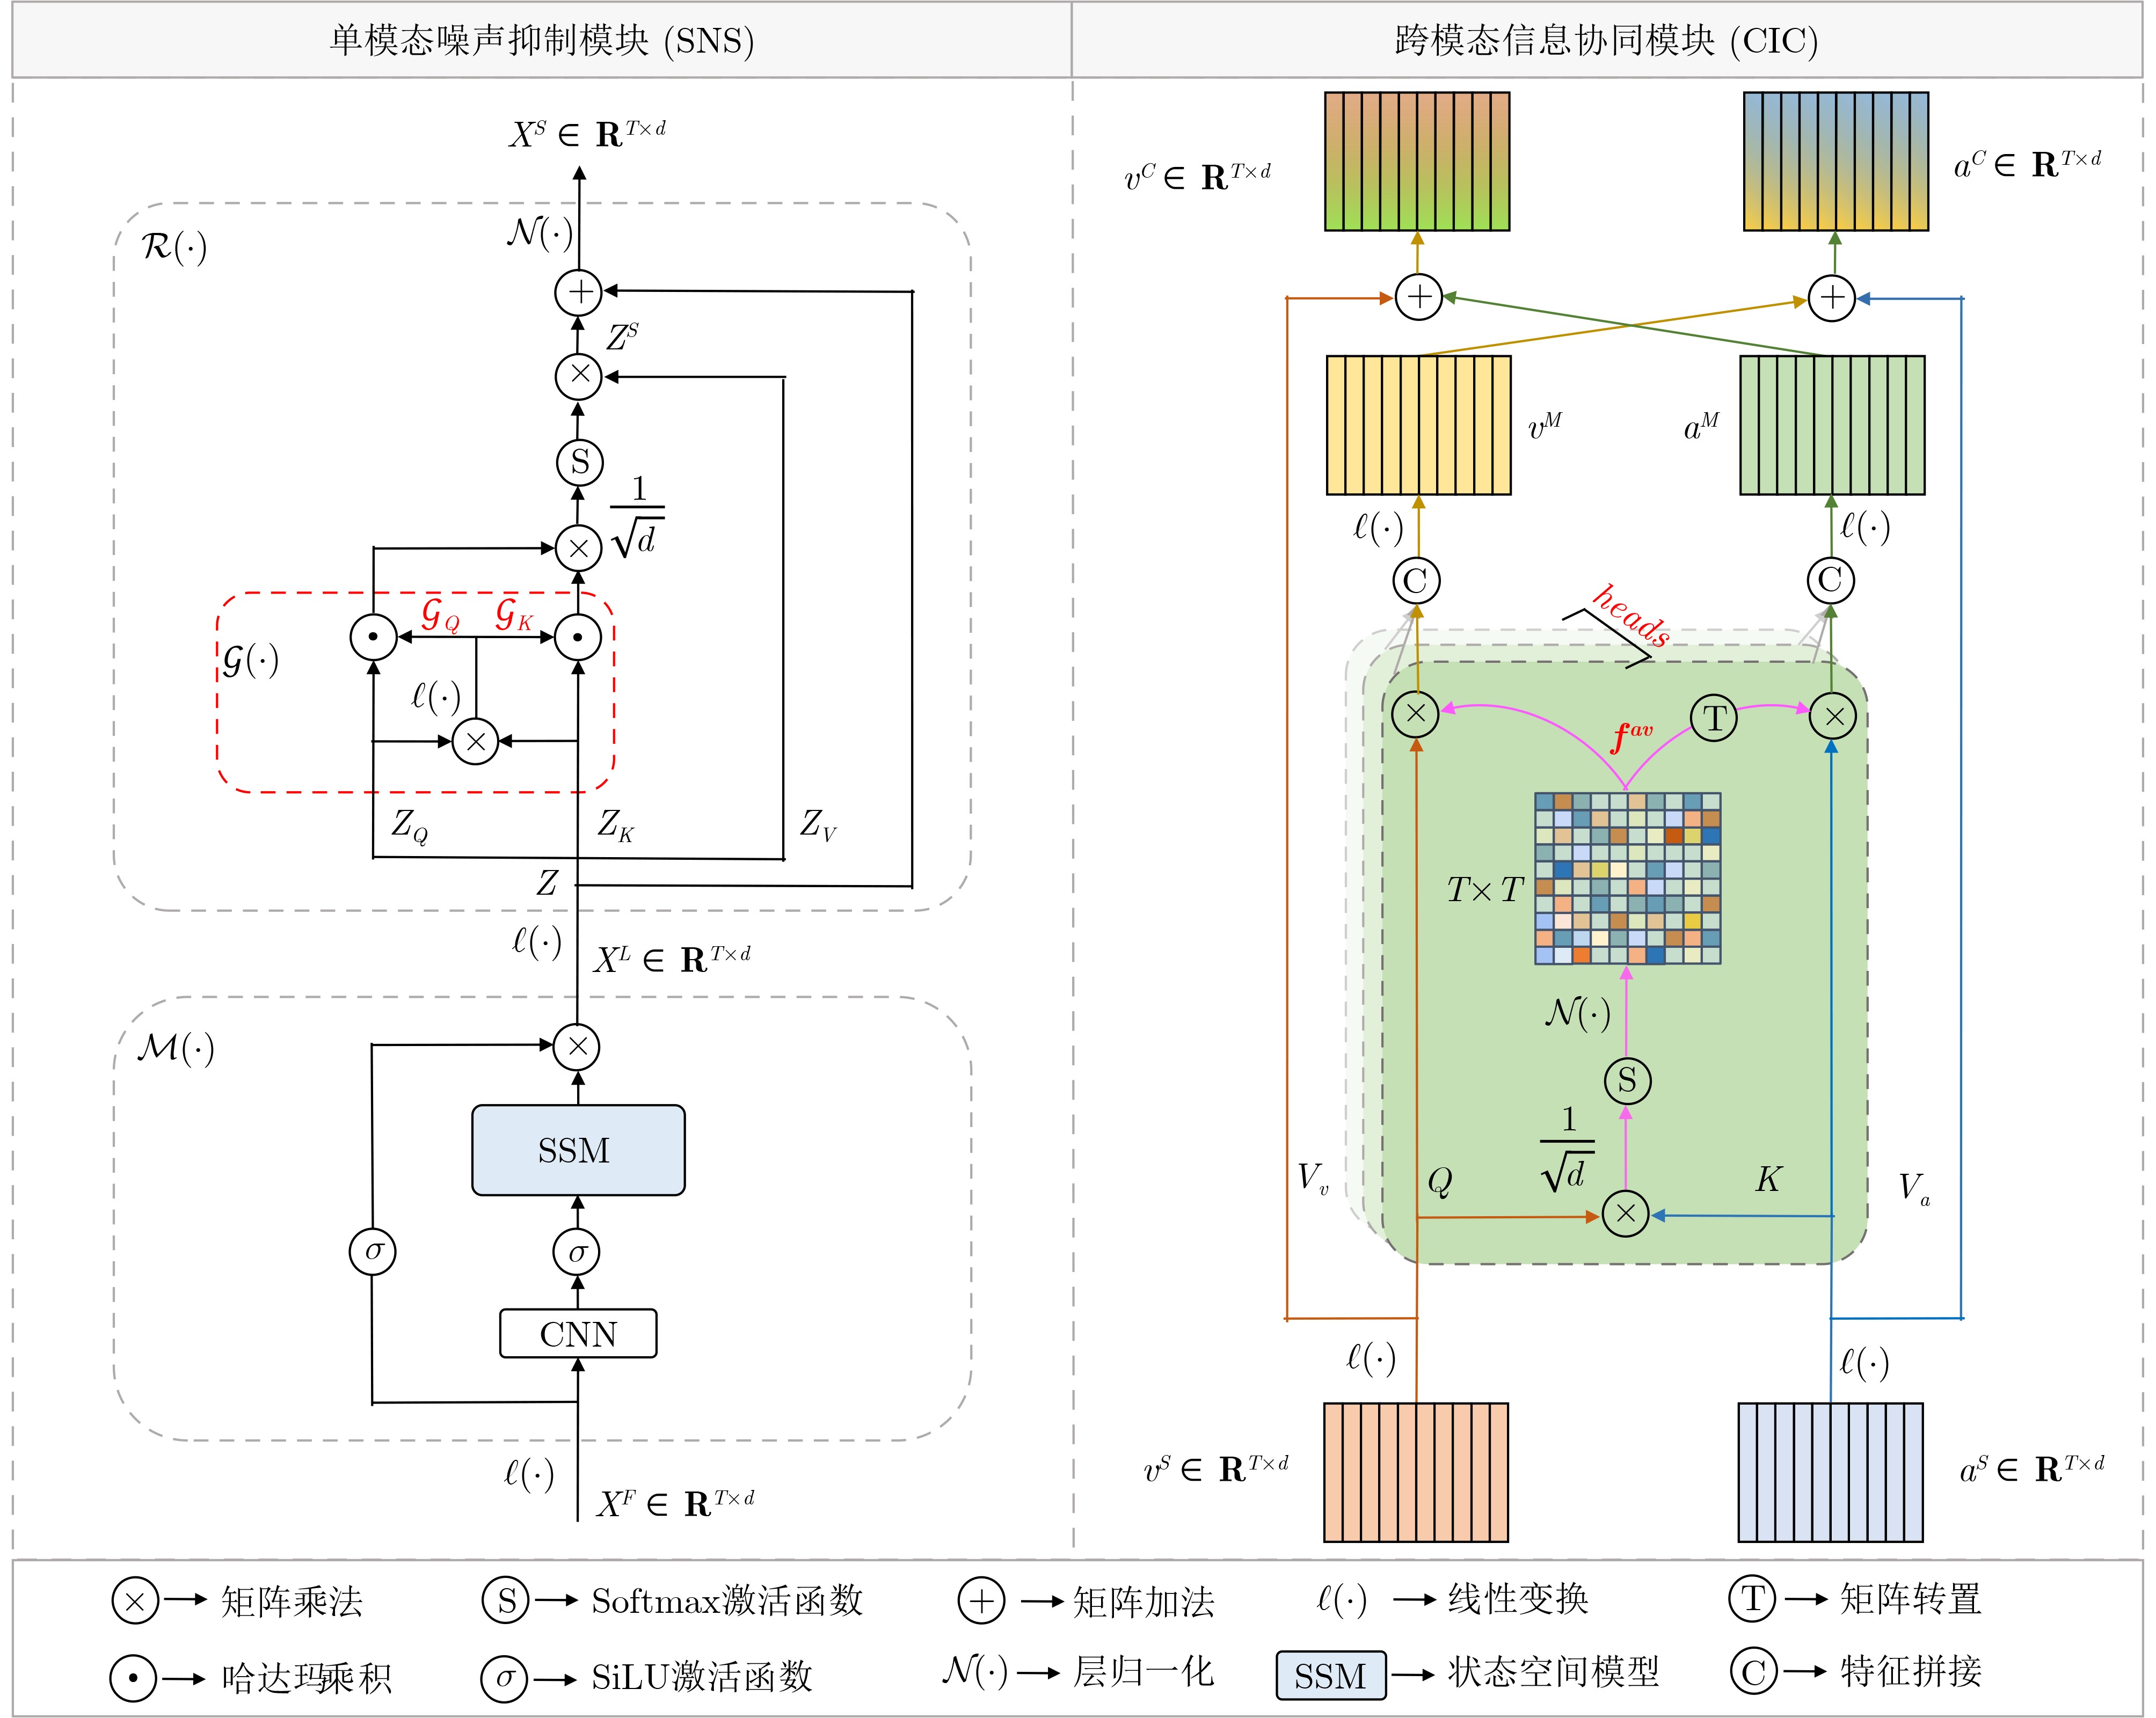
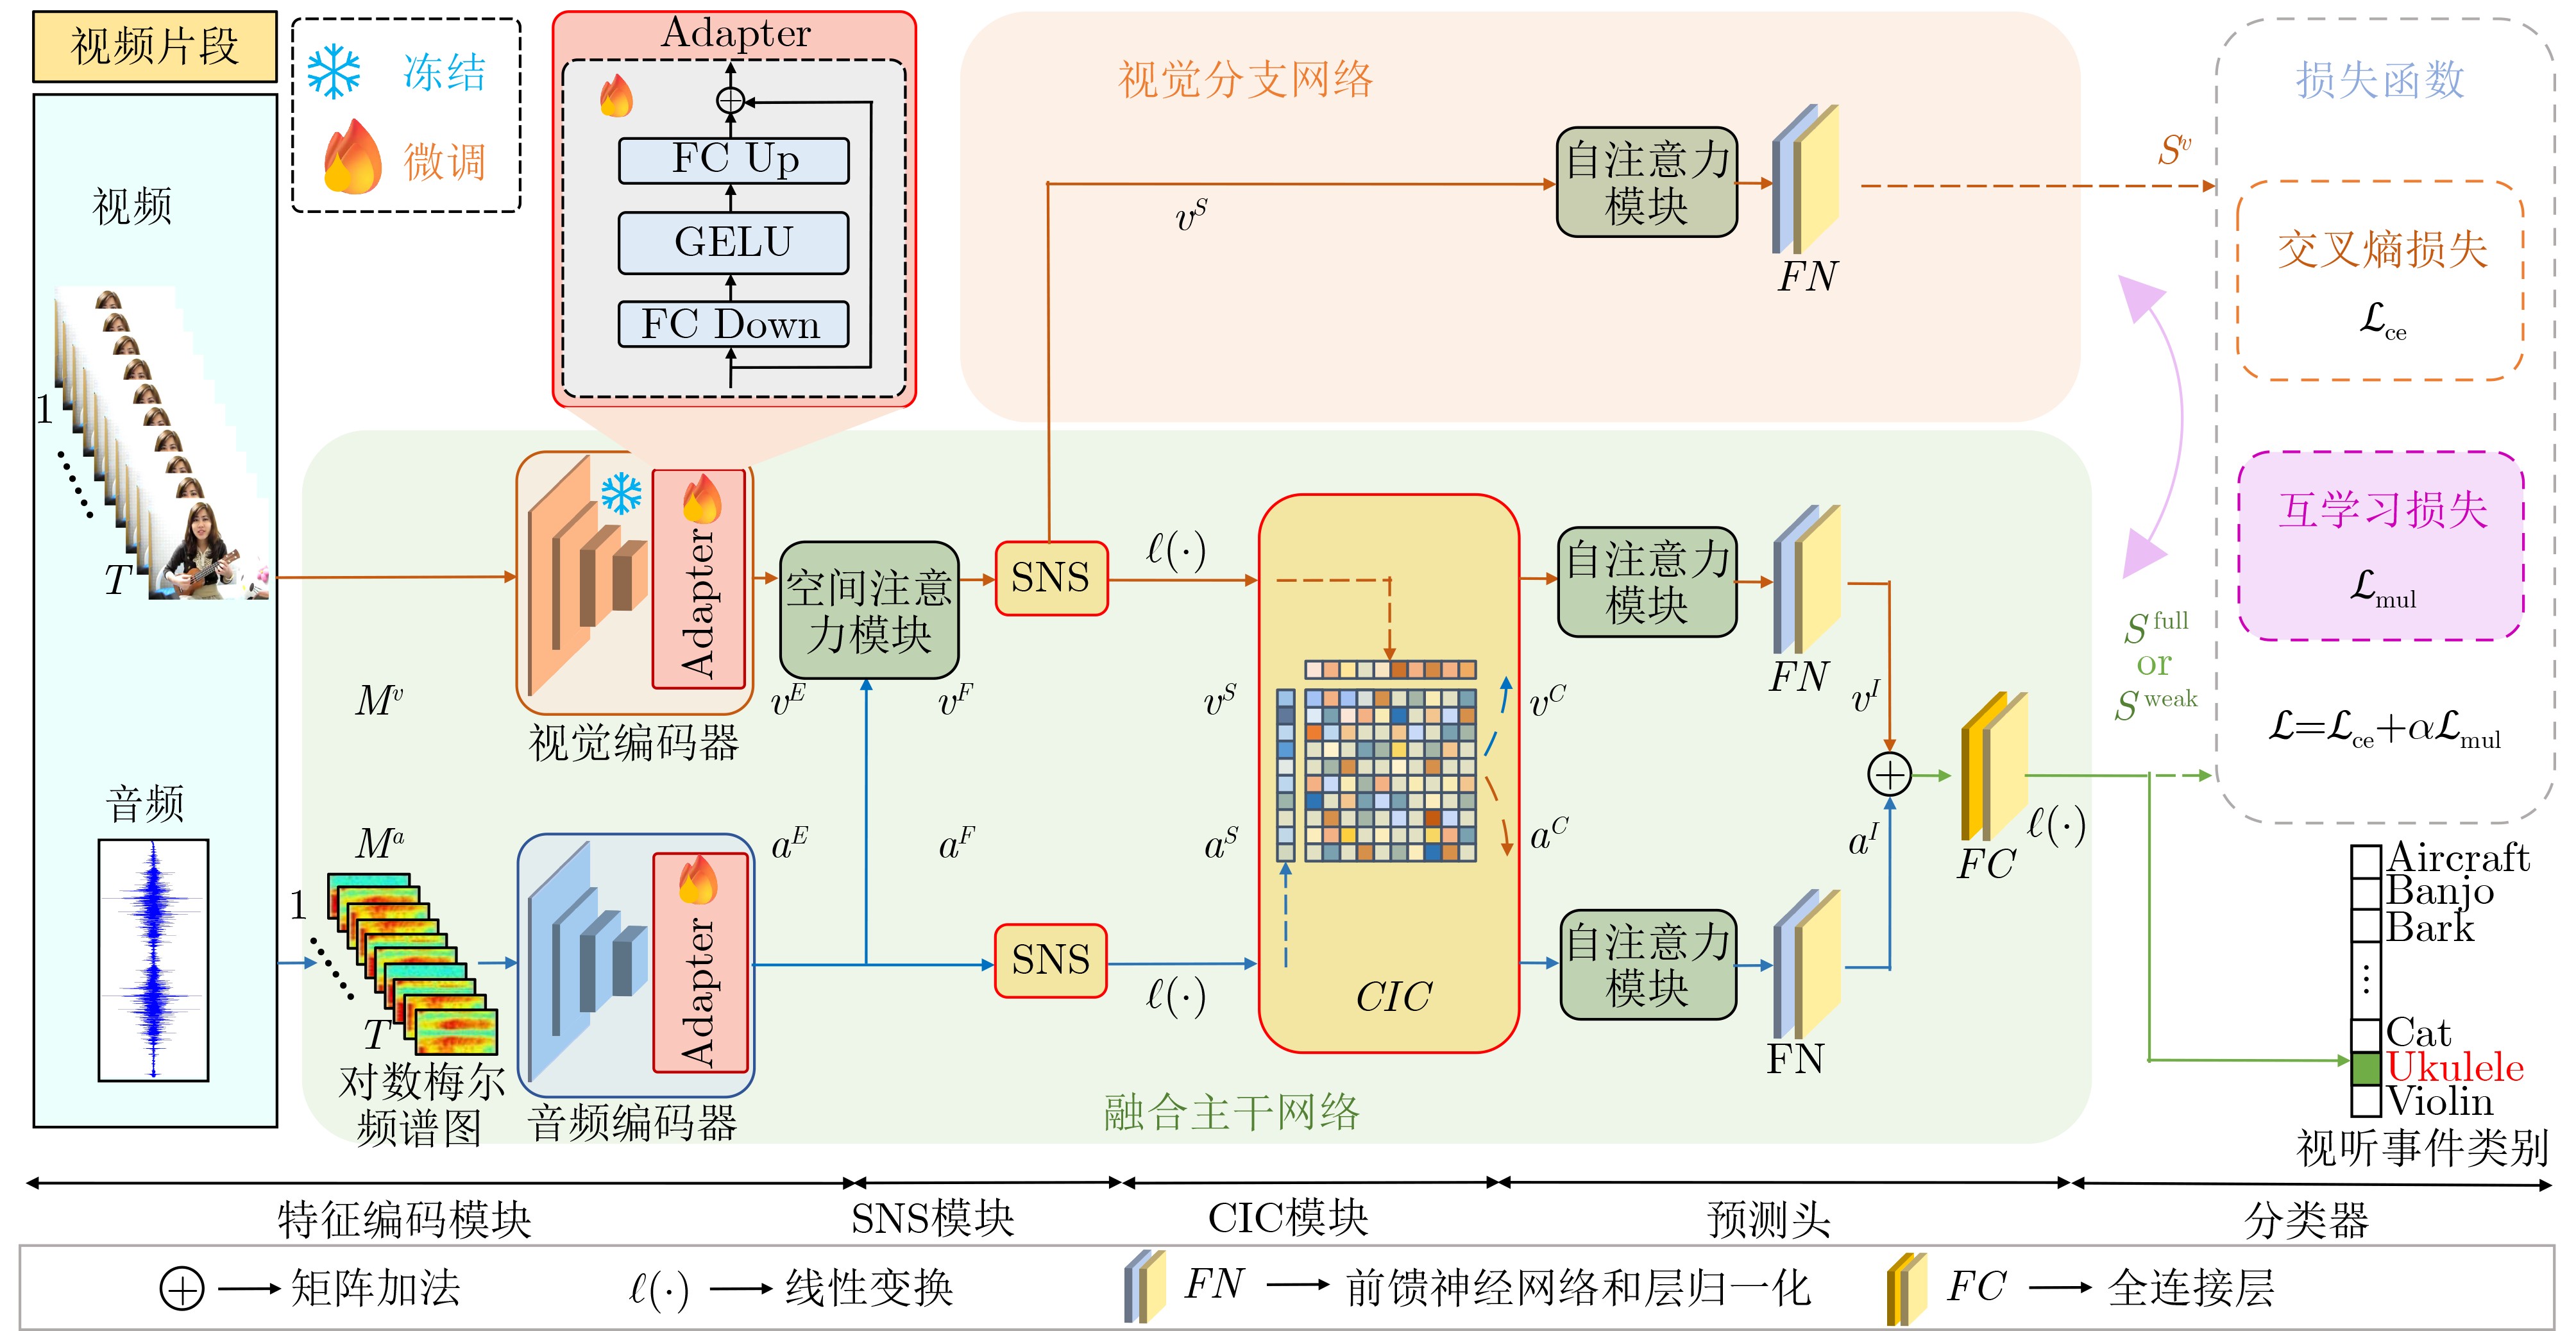
摘要: 音视频事件定位旨在识别视频中音频与视觉语义同步出现的时间片段,并判断其事件类别,是多模态视频理解领域的重要研究任务。现有方法通常采用音频分支与视觉分支独立编码后进行特征融合的范式,虽然能够利用跨模态互补信息,但在真实开放场景中,音频环境噪声、视觉背景干扰以及音视频语义不一致等问题会在融合过程中持续累积,进而削弱模型的事件定位能力。针对上述问题,本文提出一种基于视觉-语言预训练微调与多模态互学习融合的双模态联觉框架(DMSF)。该框架首先利用视觉-语言预训练模型的先验知识构建音频与视觉编码器,并设计轻量级Adapter层对编码器进行任务适配,以增强音视频语义表征能力;其次,提出单模态噪声抑制模块(SNS),通过状态空间建模和门控残差自注意力增强模态内时序建模能力;再次,提出跨模态信息协同模块(CIC),采用多头跨模态注意力实现音频与视觉特征的细粒度语义对齐;最后,引入视觉辅助分支,并通过多模态互学习机制抑制融合噪声。本文在AVE数据集上的实验结果表明,所提方法在全监督与弱监督设置下均取得了优良性能,验证了其在音视频事件定位任务中的有效性和鲁棒性。Abstract:
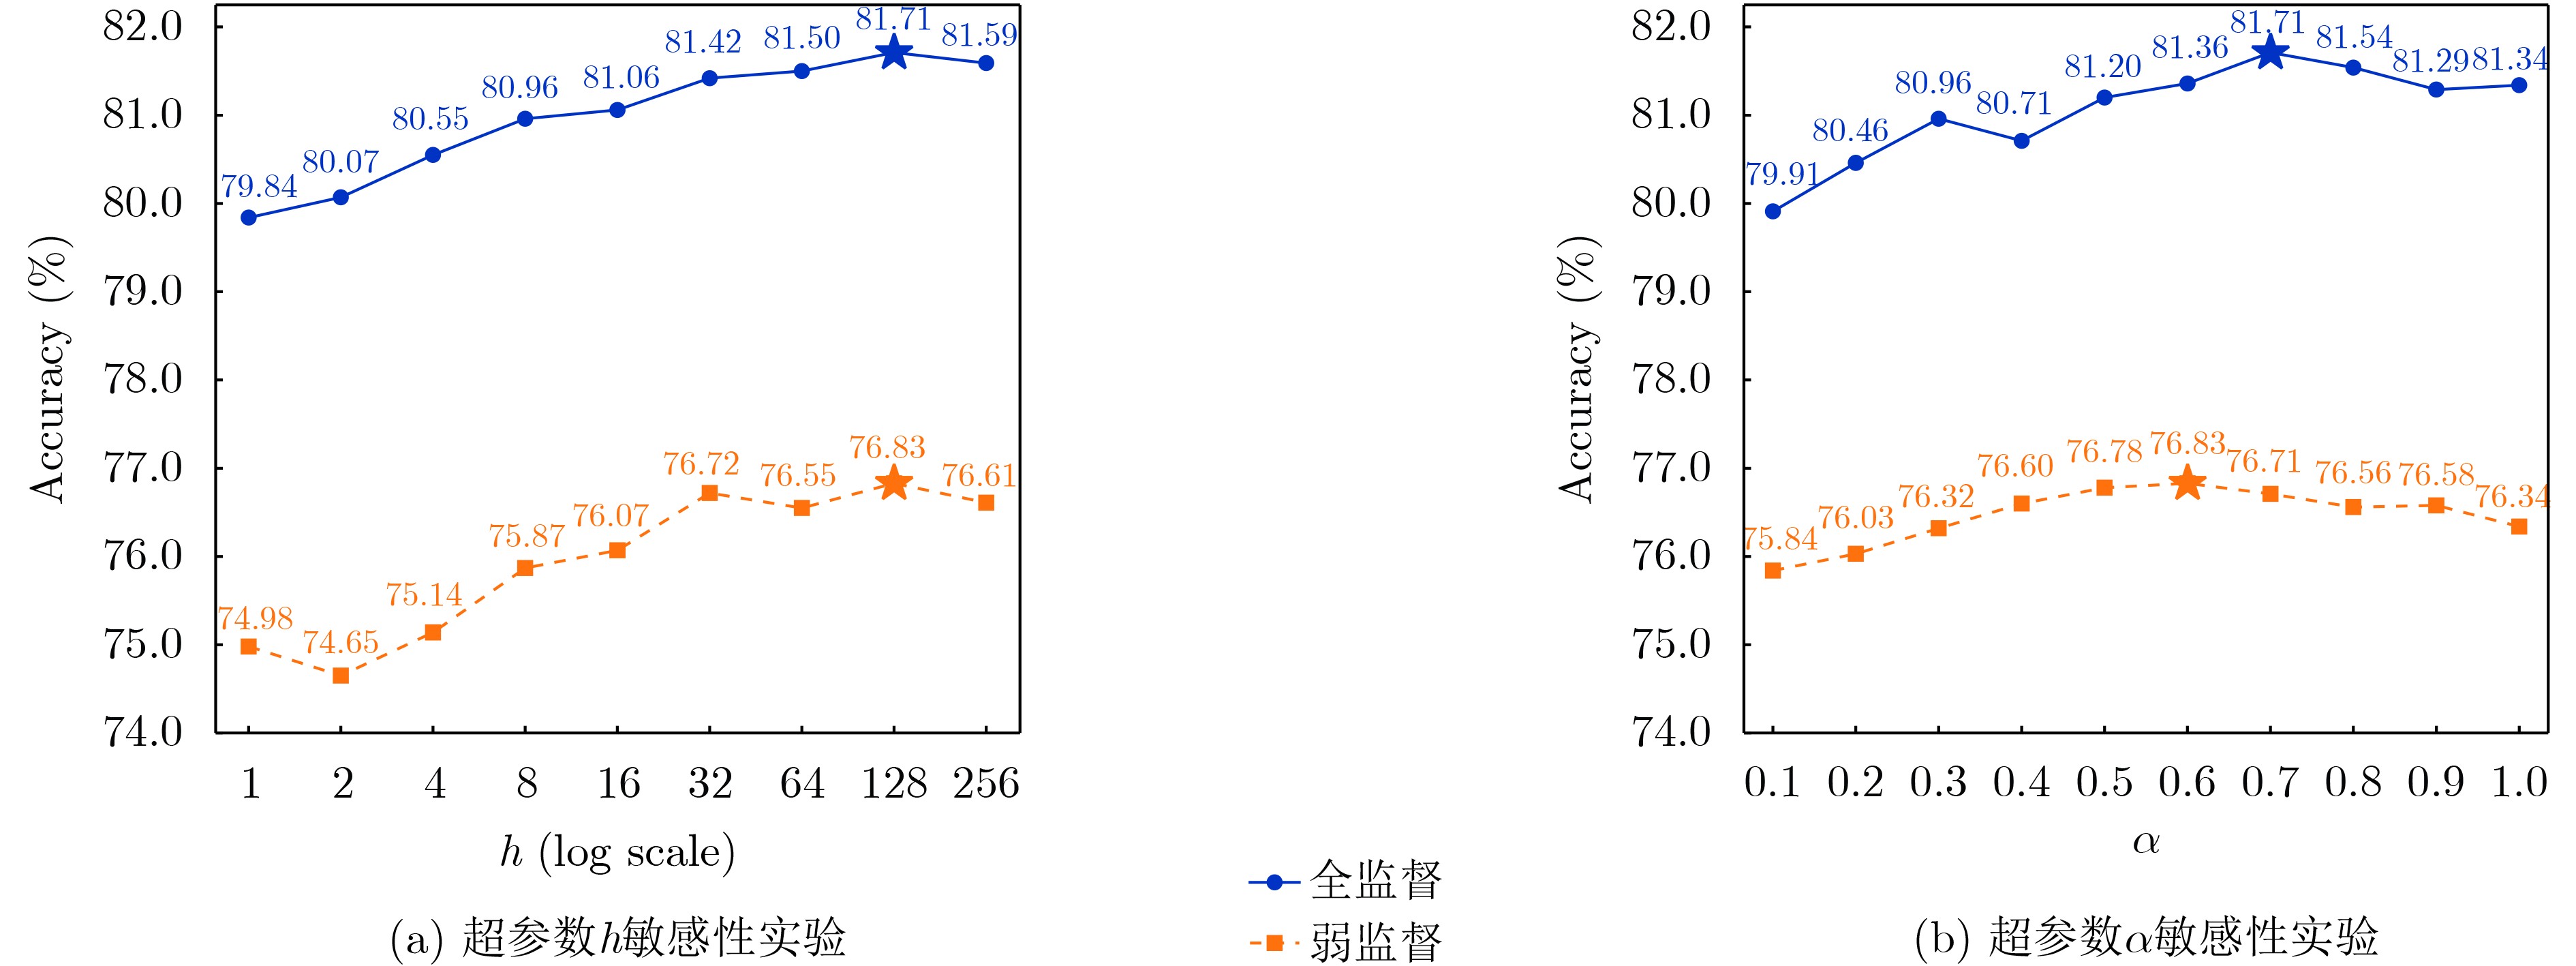
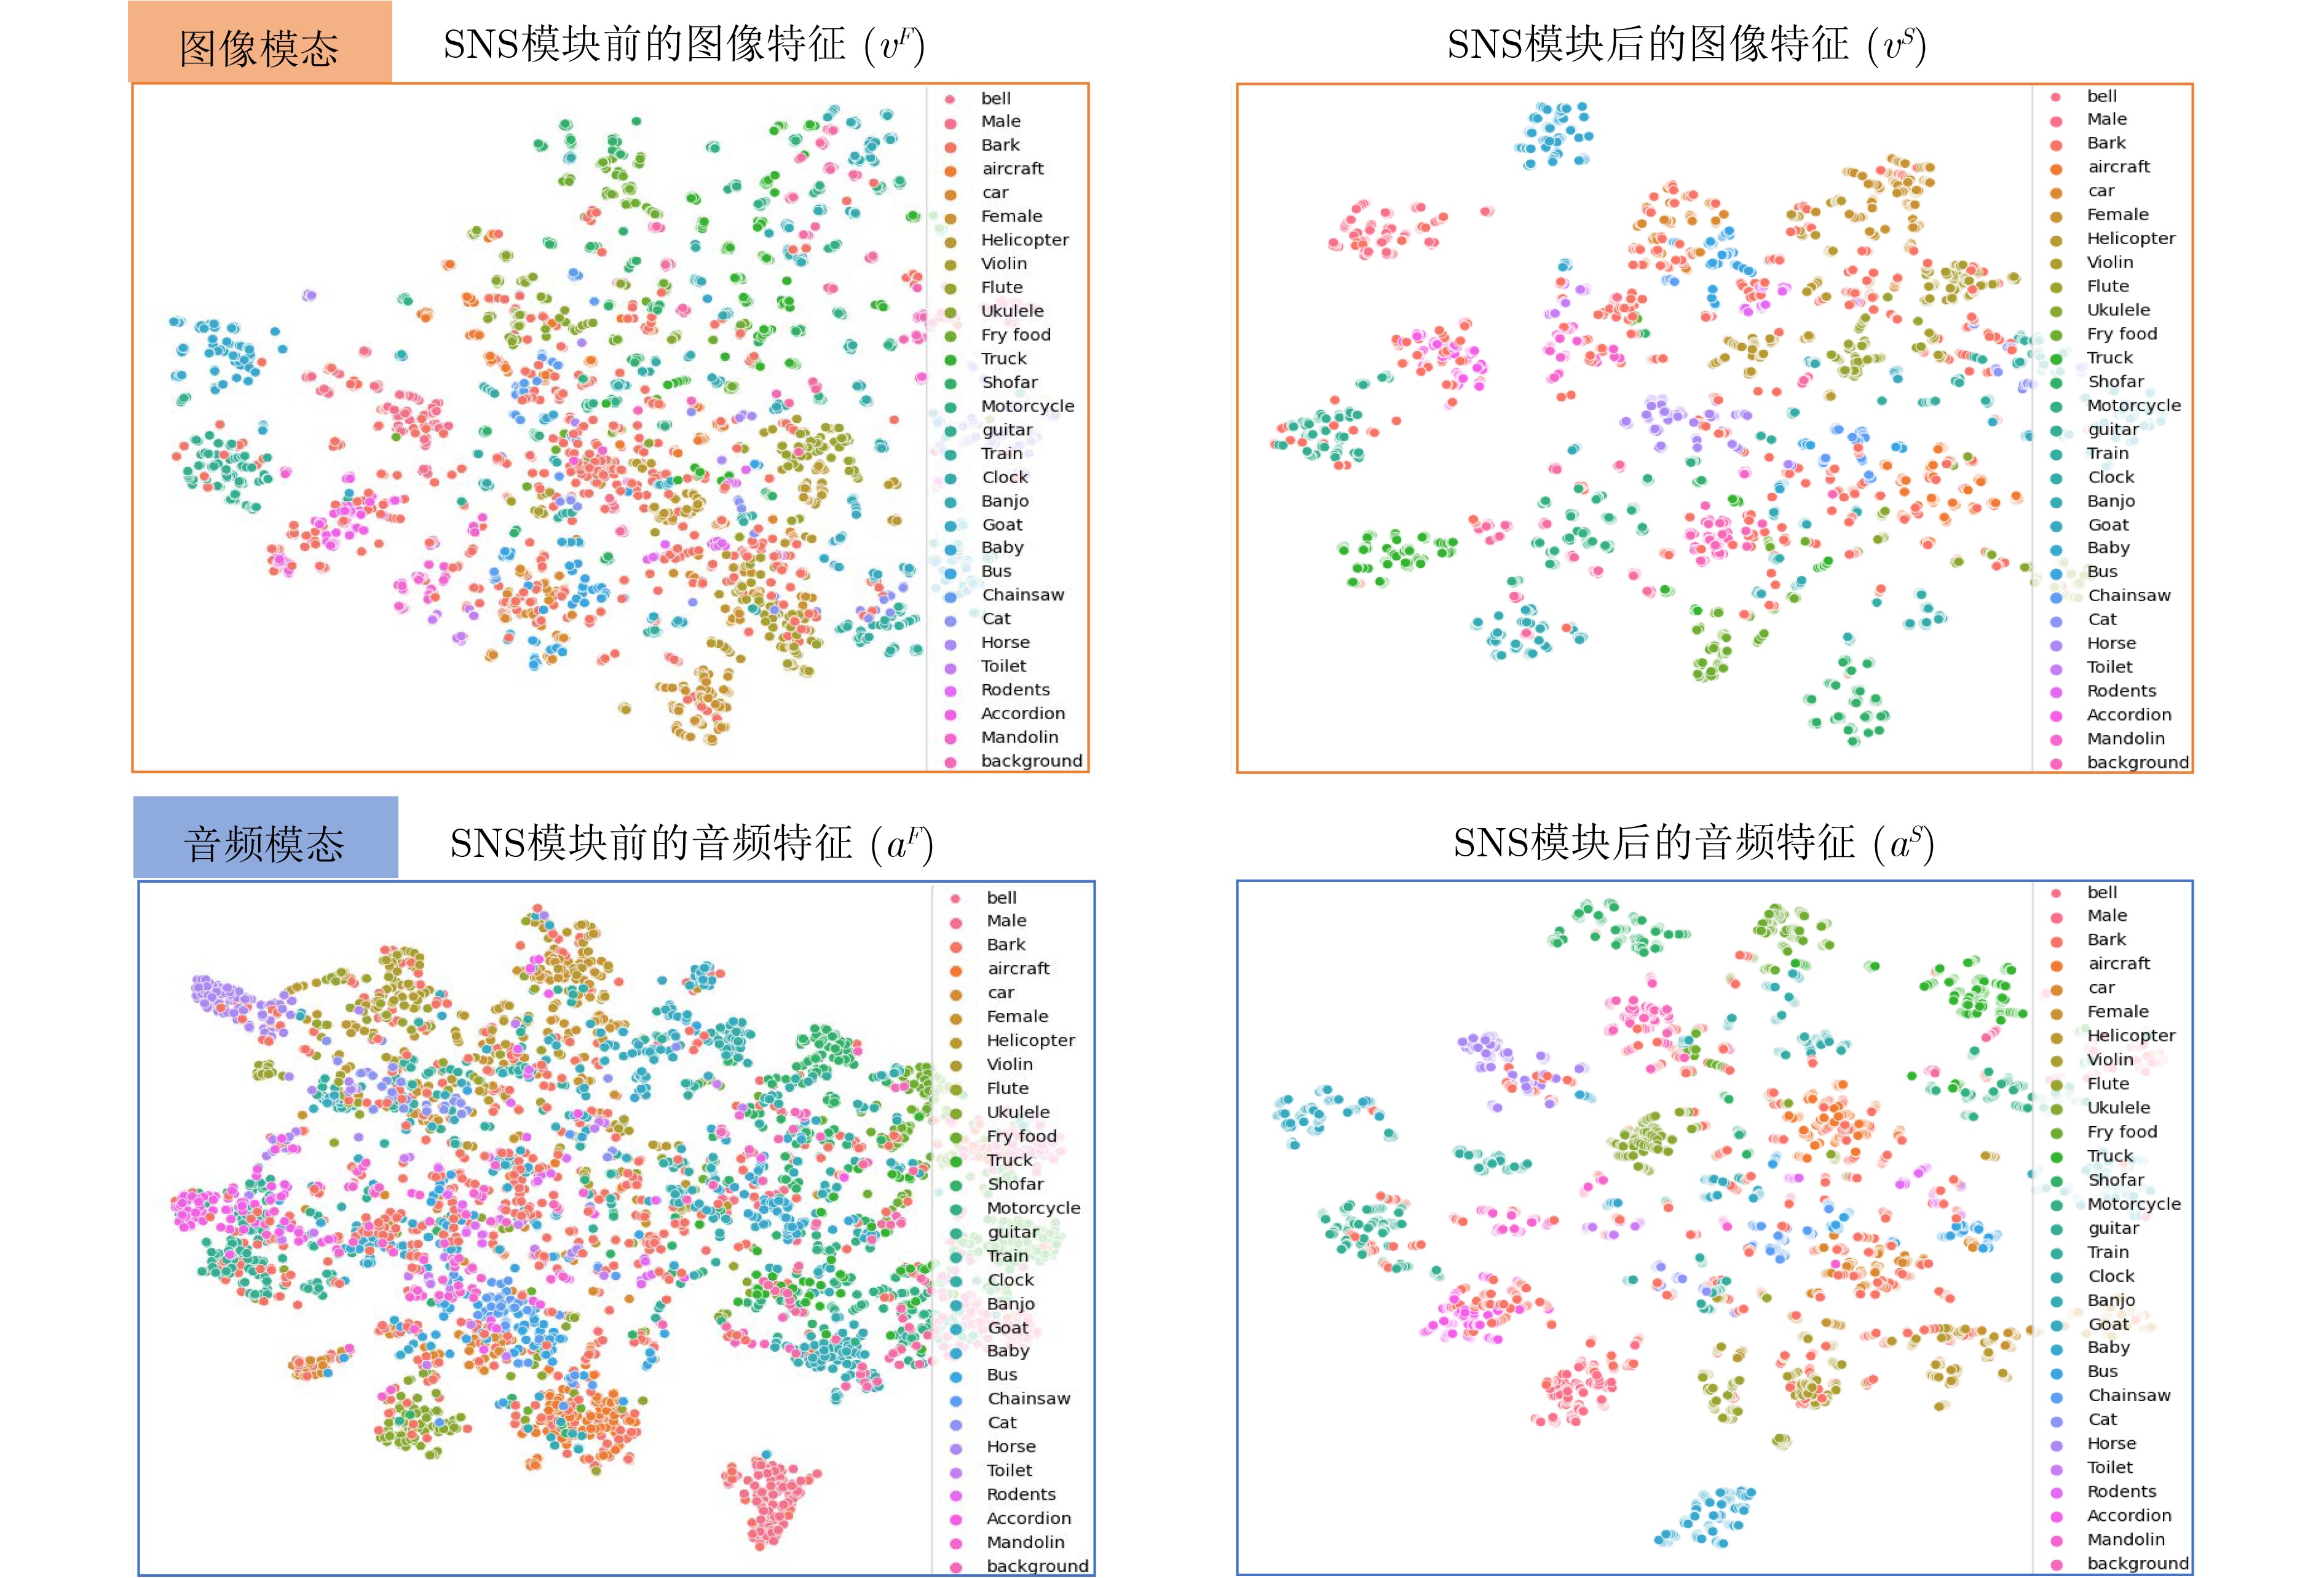
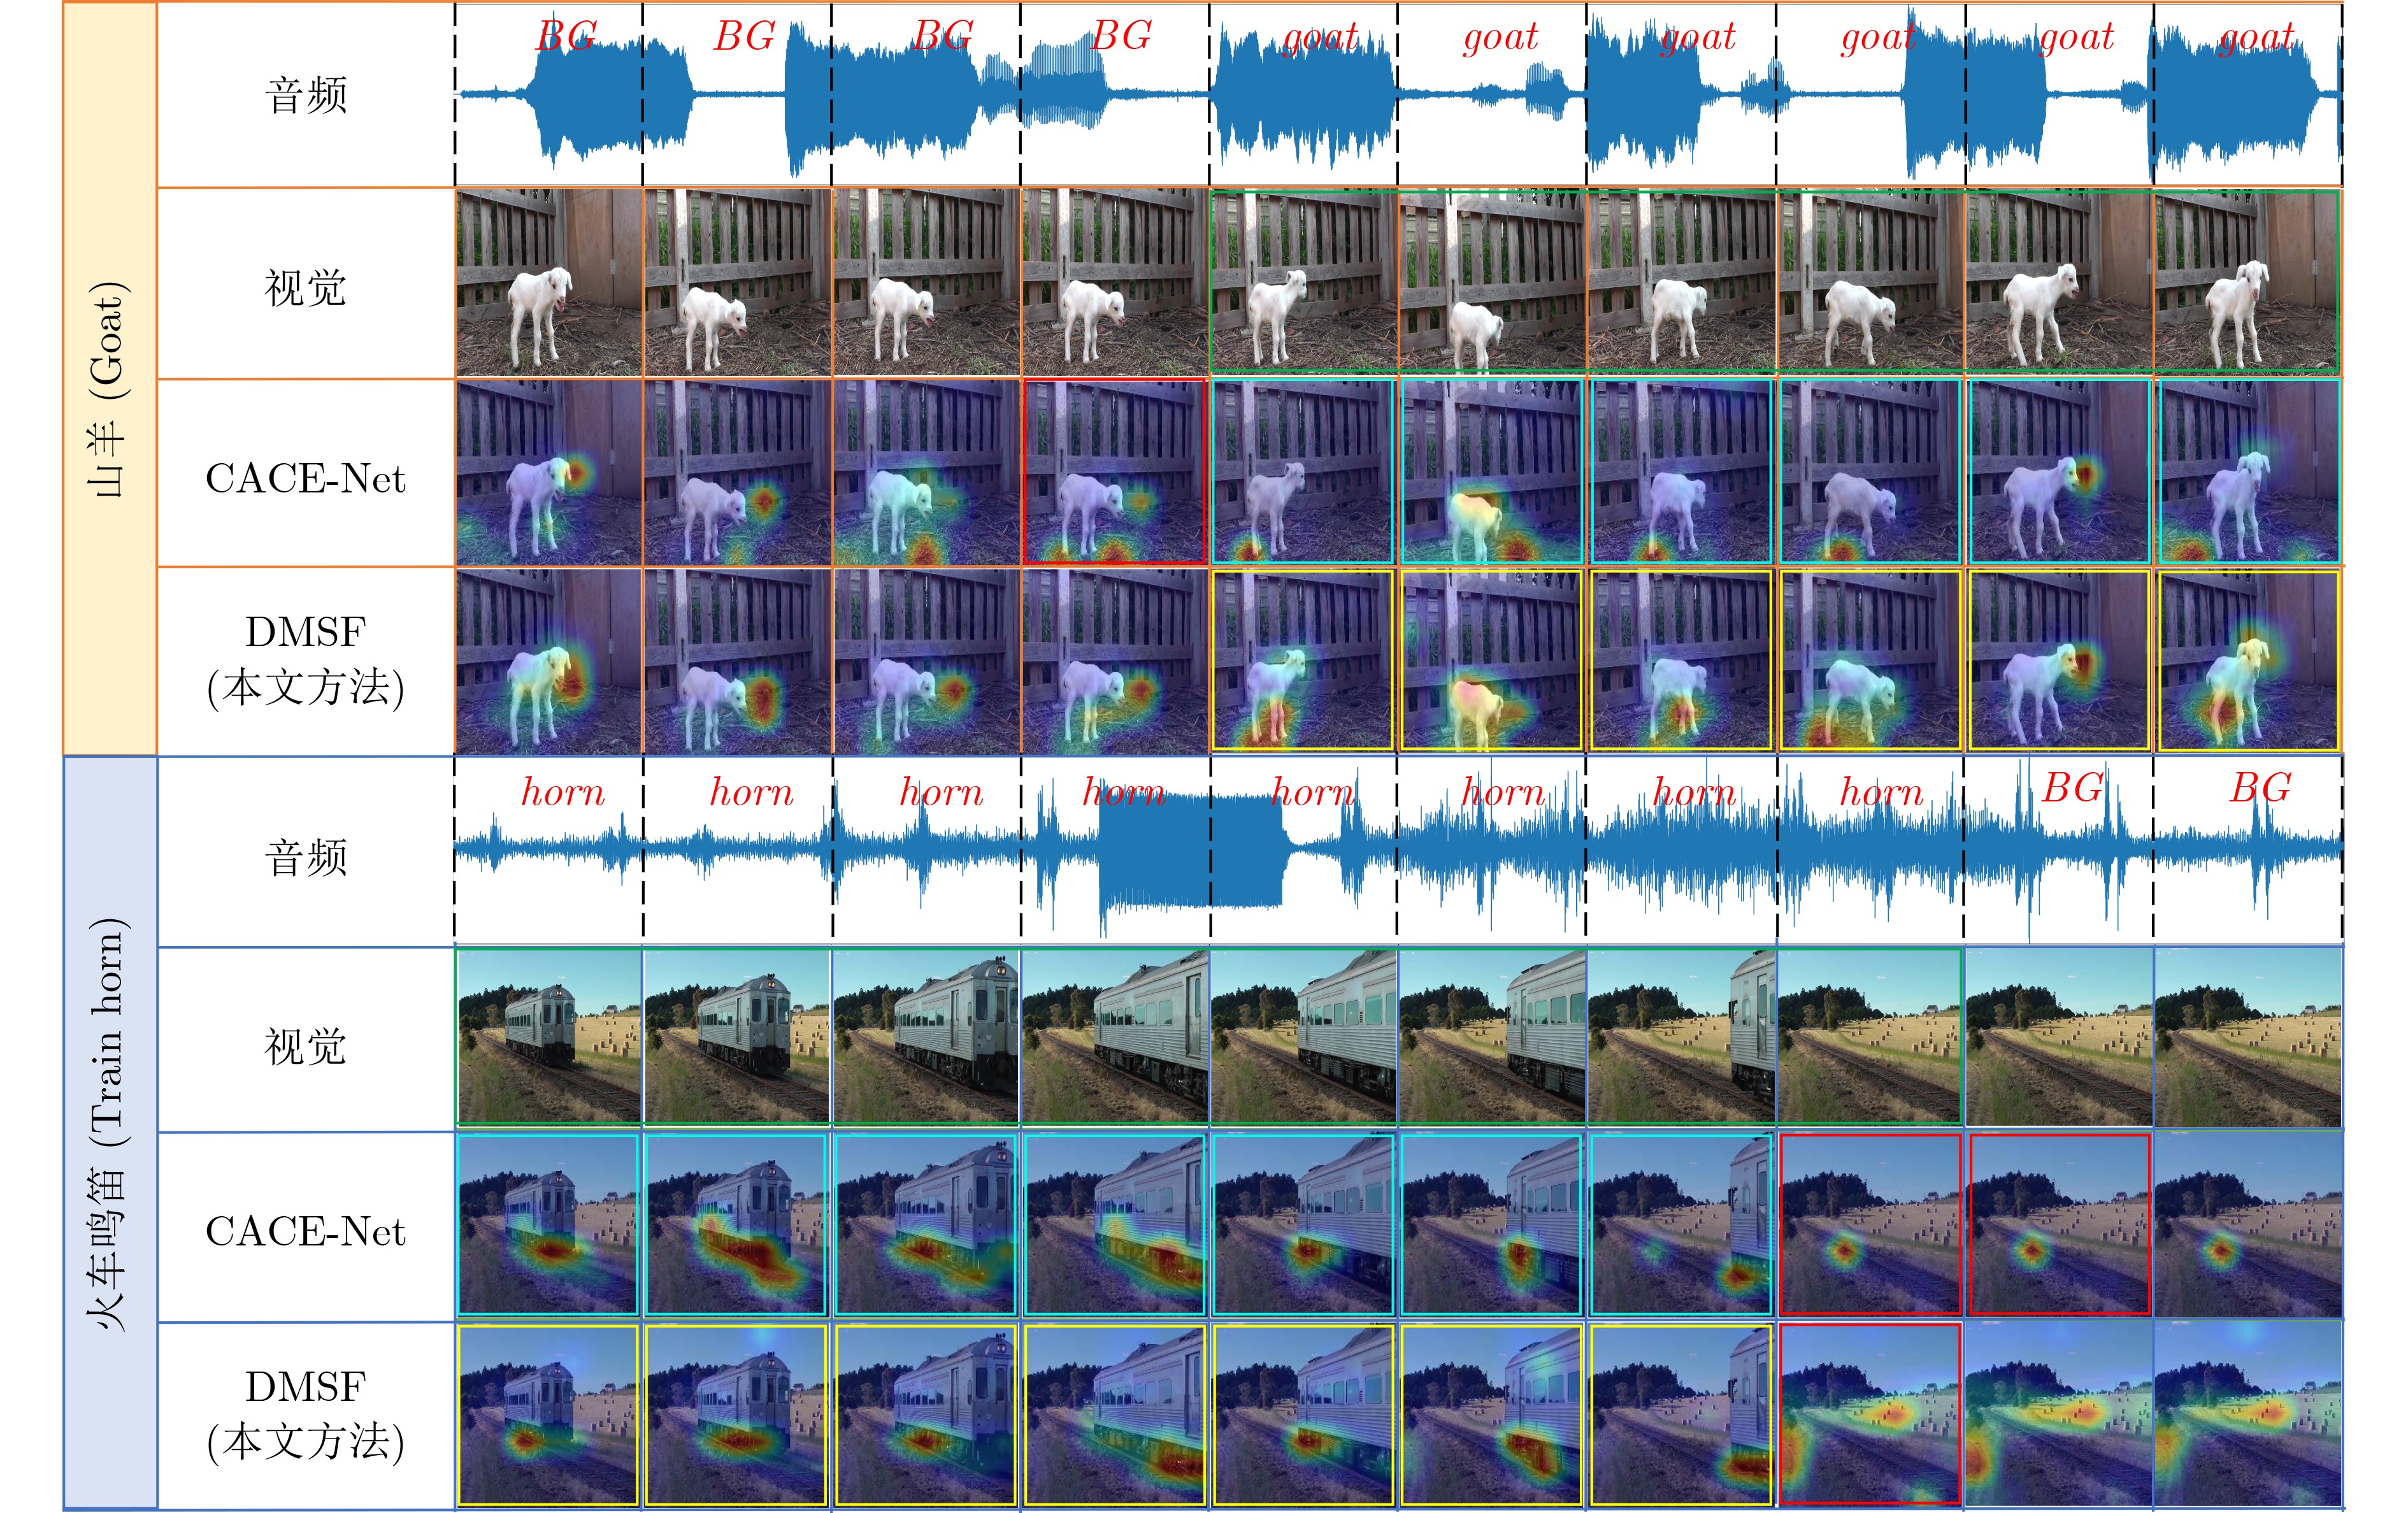
Objective Audio-visual event localization (AVEL) aims to identify temporal segments where auditory and visual cues are semantically synchronized and assign corresponding event categories. Although existing methods have achieved promising results through dual-stream feature extraction and fusion, they remain vulnerable to modality heterogeneity, background noise, and semantic misalignment in real-world scenarios. To address these challenges, this paper proposes a Vision-Language Pretraining enhanced Dual-Modal Synesthesia Framework (DMSF) for robust audio-visual event localization. Methods DMSF initializes the audio and visual encoders using knowledge transferred from vision-language pretrained models and introduces lightweight Adapter modules for task-specific adaptation while preserving the pretrained semantic representations. To mitigate intra-modal noise, a Single-modal Noise Suppression (SNS) module is designed, which leverages state-space modeling and gated self-attention to enhance temporal dependency modeling within each modality. For cross-modal interaction, a Cross-modal Information Collaboration (CIC) module based on multi-head cross-attention is introduced to establish fine-grained audio-visual alignment. Furthermore, a visual auxiliary branch is employed to preserve relatively clean visual semantics, and a mutual learning strategy is adopted to iteratively reduce fusion noise and improve representation consistency. Results and Discussions Experiments conducted on the AVE dataset demonstrate that DMSF achieves superior performance under both fully supervised and weakly supervised settings. In particular, the proposed method attains accuracies of 81.7% and 76.8% under fully supervised and weakly supervised settings, respectively. The performance improvement under weak supervision scenarios indicates that the mutual-learning strategy provides effective cross-branch constraints when fine-grained temporal annotations are unavailable. Ablation studies further validate the effectiveness of each component, including SNS, CIC, and the mutual learning mechanism. Visualization results show that DMSF produces more concentrated and semantically consistent attention distributions compared to baseline methods, especially in noisy and complex environments. Conclusions This paper presents a unified audio-visual event localization framework that integrates vision-language pretraining, intra-modal noise suppression, cross-modal collaboration, and multi-branch mutual learning. The proposed DMSF effectively enhances multimodal representation quality and mitigates noise propagation during audio-visual interaction. Extensive experimental results confirm its superiority and robustness. Future work will focus on improving instance-level semantic alignment and enhancing model interpretability in open-world multimodal scenarios. -
表 1 DMSF与主流方法在AVE数据集上的对比实验结果
模型 编码器 预训练数据集 参数量(M)↓ Acc.(%)↑ FLOPs(G)↓ 视觉 音频 视觉 音频 可学习 总参数量 全监督 弱监督 全监督 AGVA[11] ResNet-152 
VGGish ImageNet AudioSet 3.7 136.0 68.6 66.7 123.7 AVSDN[13] ResNet-152 VGGish ImageNet AudioSet 8.0 140.3 72.6 67.3 125.2 AV-Trans[14] VGG-19 VGGish ImageNet AudioSet 15.8 231.5 76.8 70.2 207.9 CMRAN[12] ResNet-152 VGGish ImageNet AudioSet 15.9 148.2 77.4 72.9 127.0 MM-Pyramid[20] ResNet-152 VGGish ImageNet AudioSet 44.0 176.3 77.8 73.5 130.5 PSP[15] VGG-19 VGGish ImageNet AudioSet 1.7 217.4 77.8 73.5 205.4 CMBS[16] ResNet-152 VGGish ImageNet AudioSet 14.4 216.7 79.3 74.2 126.8 CACE-Net*[21] VGG-19 VGGish ImageNet AudioSet 50.1 50.1 80.8 − 206.2 AVMoE*[25] ResNet-152 VGGish 
ImageNet AudioSet 383.1 384.2 14.9 − 132.6 LAVISH[23] ViT-B-16 共享 ImageNet × 4.7 107.2 75.3 − 362.1 ViT-L-14 共享 ImageNet × 14.5 340.1 78.1 − 1648.9 EPMI[26] ViT-B-16 共享 ImageNet × 0.6 87.0 76.4 − 355.4 ViT-L-14 共享 ImageNet × 0.8 305.0 76.9 − 1662.0 DMSF(本文方法) ViT-B-16 ResNeXt CLIP AudioSet 18.8 101.7 78.7 74.3 223.6 ViT-L-14 ResNeXt CLIP AudioSet 78.3 290.6 81.7 76.8 821.3  下载: 导出CSV
表 2 基于AVE数据集的模块消融实验结果
模型 Acc.(%)↑ 全监督 弱监督 w/o SNS & CIC 72.21 54.97 w/o SNS 79.74 74.82 w/o CIC 81.06 75.33 DMSF(本文方法) 81.71 76.83
下载: 导出CSV
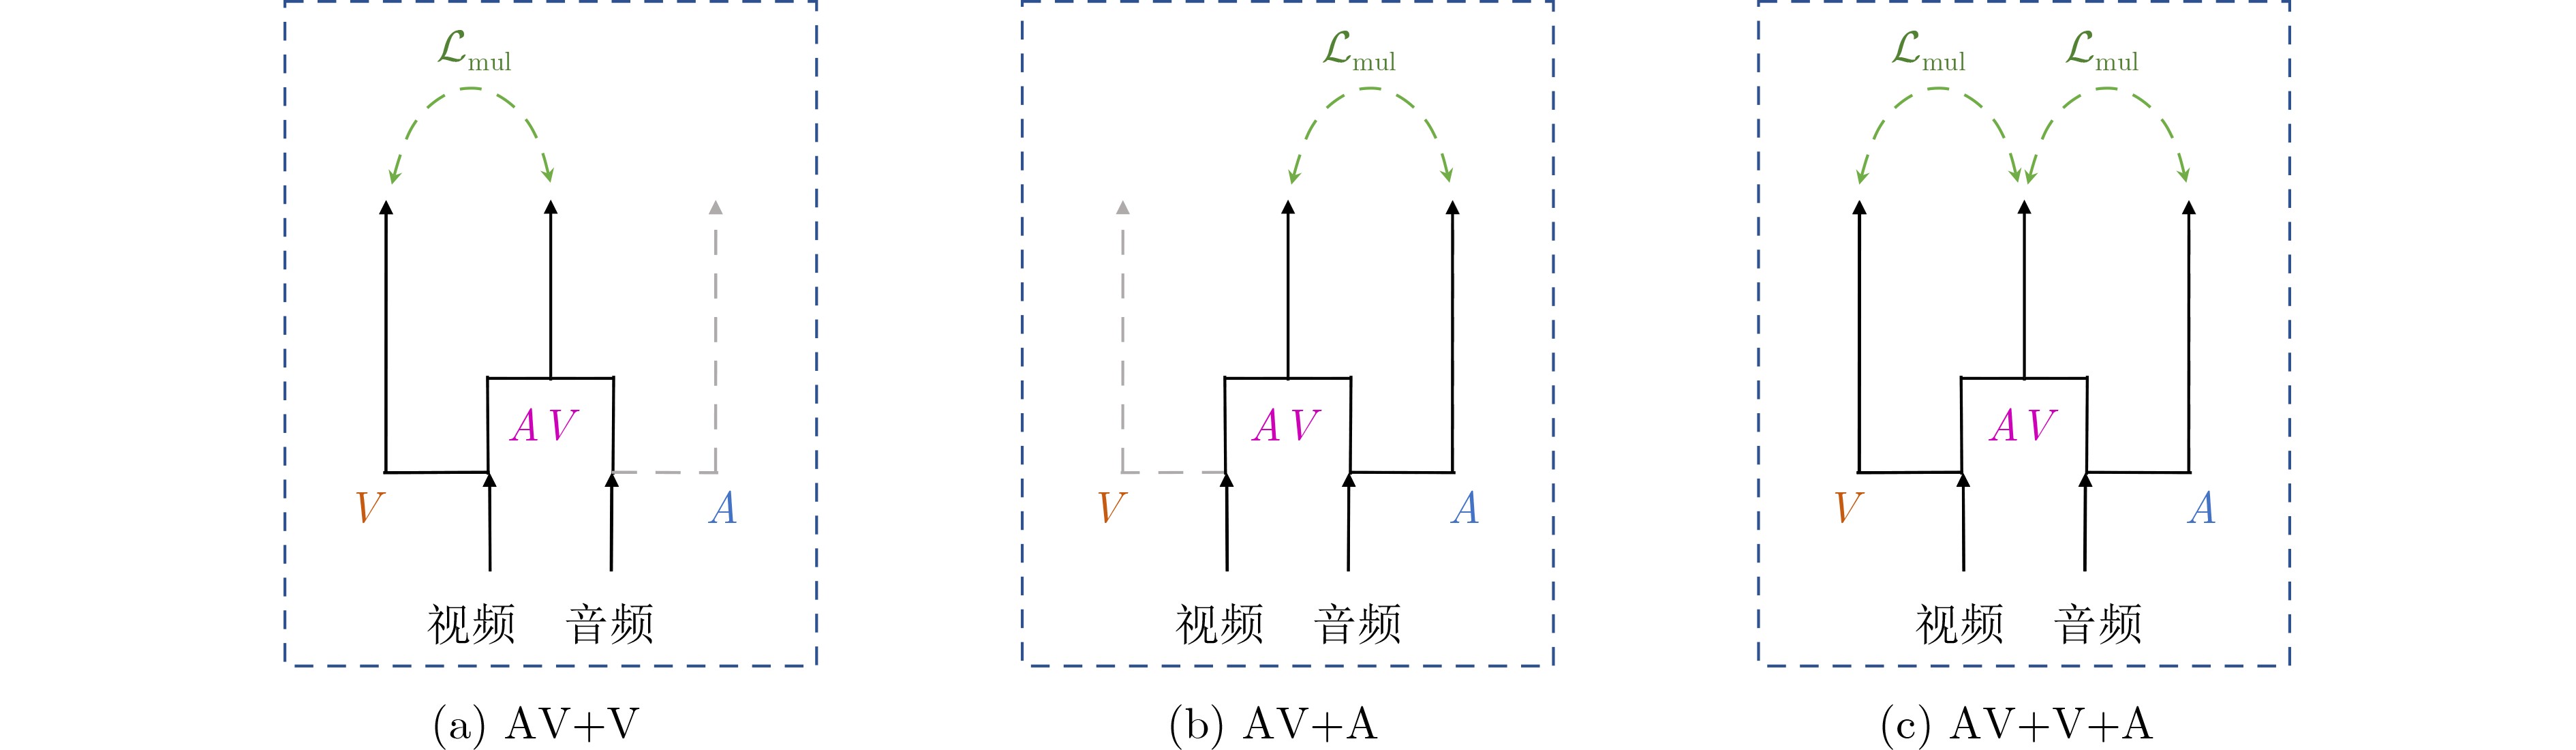
表 3 基于AVE数据集的互学习分支模式消融实验结果
分支模式 Acc.(%)↑ AV A V 全监督 弱监督 √ × × 78.01 73.67 √ × √ 81.71 76.83 √ √ × 78.70 71.86 √ √ √ 80.77 74.87
下载: 导出CSV
表 4 基于AVE数据集的SNS模块消融实验结果
模型 Acc.(%)↑ 全监督 弱监督 Transformer Encoder 80.52 75.66 SSM 81.07 76.15 SSM+Attention(本文方法) 81.71 76.83
下载: 导出CSV
表 5 基于AVE数据集的损失函数消融实验结果
损失函数 Acc.(%)↑ 全监督 弱监督 $ {\mathcal{L}}_{ce} $ 81.63 75.09 $ {\mathcal{L}}_{\text{mul}} $ 65.46 55.70 $ {\mathcal{L}}_{\text{ce}}+\alpha {\mathcal{L}}_{\text{mul}} $ 81.71 76.83
下载: 导出CSV
-
[1] 李玉鑑. 认知相对论—通向强人工智能之路[J]. 电子与信息学报, 2024, 46(2): 408–427. doi: 10.11999/JEIT230749.LI Yujian. Theory of cognitive relativity — the road to strong artificial intelligence[J]. Journal of Electronics & Information Technology, 2024, 46(2): 408–427. doi: 10.11999/JEIT230749. [2] 李哲, 王可, 王彪, 等. 人机融合智能决策: 概念、框架与应用[J]. 电子与信息学报, 2025, 47(10): 3439–3464. doi: 10.11999/JEIT250260.LI Zhe, WANG Ke, WANG Biao, et al. Human-machine fusion intelligent decision-making: Concepts, framework, and applications[J]. Journal of Electronics & Information Technology, 2025, 47(10): 3439–3464. doi: 10.11999/JEIT250260. [3] 李学龙. 多模态认知计算[J]. 中国科学: 信息科学, 2023, 53(1): 1–32. doi: 10.1360/SSI-2022-0226.LI Xuelong. Multi-modal cognitive computing[J]. Scientia Sinica (Informationis), 2023, 53(1): 1–32. doi: 10.1360/SSI-2022-0226. [4] 孙强, 陈远. 多层次时空特征自适应集成与特有-共享特征融合的双模态情感识别[J]. 电子与信息学报, 2024, 46(2): 574–587. doi: 10.11999/JEIT231110.SUN Qiang and CHEN Yuan. Bimodal emotion recognition with adaptive integration of multi-level spatial-temporal features and specific-shared feature fusion[J]. Journal of Electronics & Information Technology, 2024, 46(2): 574–587. doi: 10.11999/JEIT231110. [5] 孙立峰, 宋新航, 蒋树强, 等. 多模态协同感知与融合技术专题前言[J]. 软件学报, 2024, 35(5): 2099–2100. doi: 10.13328/j.cnki.jos.007030.SUN Lifeng, SONG Xinhang, JIANG Shuqiang, et al. Special topic on multimodal collaborative perception and fusion preface[J]. Journal of Software, 2024, 35(5): 2099–2100. doi: 10.13328/j.cnki.jos.007030. [6] 张北辰, 李亮, 查正军, 等. 基于跨模态对比学习的视觉问答主动学习方法[J]. 计算机学报, 2022, 45(8): 1730–1745. doi: 10.11897/SP.J.1016.2022.0173.ZHANG Beichen, LI Liang, ZHA Zhengjun, et al. Contrastive cross-modal representation learning based active learning for visual question answer[J]. Chinese Journal of Computers, 2022, 45(8): 1730–1745. doi: 10.11897/SP.J.1016.2022.0173. [7] 赵朝阳, 朱贵波, 王金桥. ChatGPT给语言大模型带来的启示和多模态大模型新的发展思路[J]. 数据分析与知识发现, 2023, 7(3): 26–35. doi: 10.11925/infotech.2096-3467.2023.0216.ZHAO Chaoyang, ZHU Guibo, and WANG Jinqiao. The inspiration brought by ChatGPT to LLM and the new development ideas of multi-modal large model[J]. Data Analysis and Knowledge Discovery, 2023, 7(3): 26–35. doi: 10.11925/infotech.2096-3467.2023.0216. [8] 彭敏轩, 梁艳. 基于双流门控视听融合的多模态语音增强[J]. 计算机系统应用, 2025, 34(11): 127–138. doi: 10.15888/j.cnki.csa.009996.PENG Minxuan and LIANG Yan. Multi-modal speech enhancement based on dual-stream gated audio-visual fusion[J]. Computer Systems and Applications, 2025, 34(11): 127–138. doi: 10.15888/j.cnki.csa.009996. [9] 章佳妍, 续欣莹, 谢珺, 等. 融合关键区域增强与双向语义引导的视听定位[J]. 计算机工程与应用, 2026, 62(3): 207–217. doi: 10.3778/j.issn.1002–8331.2411-0435.ZHANG Jiayan, XU Xinying, XIE Jun, et al. Audio-visual localization with key region enhancement and bidirectional semantic guidance[J]. Computer Engineering and Applications, 2026, 62(3): 207–217. doi: 10.3778/j.issn.1002-8331.2411-0435. doi: 10.3778/j.issn.1002–8331.2411-0435. [10] LIU Chen, YANG Liying, LI Peike, et al. Dynamic derivation and elimination: Audio visual segmentation with enhanced audio semantics[C]. 2025 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Nashville, USA, 2025: 3131–3141. doi: 10.1109/CVPR52734.2025.00298. [11] VILAÇA L, YU Yi, and VIANA P. A survey of recent advances and challenges in deep audio-visual correlation learning[J]. ACM Computing Surveys, 2025, 57(12): 299. doi: 10.1145/3696445. [12] YE Qilang, YU Zitong, SHAO Rui, et al. CAT+: Investigating and enhancing audio-visual understanding in large language models[J]. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2025, 47(10): 8674–8690. doi: 10.1109/TPAMI.2025.3582389. [13] BANDARA T R, GOSTAR A K, ABEYSINGHE P, et al. Occlusion handling for intelligent vehicles using audio-visual multi-object tracking[J]. IEEE Transactions on Intelligent Transportation Systems, 2026, 27(9): 11578–11593. doi: 10.1109/TITS.2026.3697405. [14] TIAN Yapeng, SHI Jing, LI Bochen, et al. Audio-visual event localization in unconstrained videos[C]. 2018 15th European Conference on Computer Vision (ECCV), Munich, Germany, 2018: 252–268. doi: 10.1007/978-3-030-01216-8_16. [15] XU Haoming, ZENG Runhao, WU Qingyao, et al. Cross-modal relation-aware networks for audio-visual event localization[C]. 2020 28th ACM International Conference on Multimedia (ACM MM), Seattle, USA, 2020: 3893–3901. doi: 10.1145/3394171.3413581. [16] LIN Yanbo, LI Y J, and WANG Y C F. Dual-modality seq2seq network for audio-visual event localization[C]. 2019 44th IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), Brighton, UK, 2019: 2002–2006. doi: 10.1109/ICASSP.2019.8683226. [17] LIN Yanbo and WANG Y C F. Audiovisual transformer with instance attention for audio-visual event localization[C]. 2020 15th Asian Conference on Computer Vision (ACCV), Kyoto, Japan, 2021: 274–290. doi: 10.1007/978-3-030-69544-6_17. [18] ZHOU Jinxing, ZHENG Liang, ZHONG Yiran, et al. Positive sample propagation along the audio-visual event line[C]. 2021 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Nashville, USA, 2021: 8432–8440. doi: 10.1109/CVPR46437.2021.00833. [19] XIA Yan and ZHAO Zhou. Cross-modal background suppression for audio-visual event localization[C]. 2022 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), New Orleans, USA, 2022: 19957–19966. doi: 10.1109/CVPR52688.2022.01936. [20] XUAN Hanyu, ZHANG Zhenyu, CHEN Shuo, et al. Cross-modal attention network for temporal inconsistent audio-visual event localization[C]. 2020 34th AAAI Conference on Artificial Intelligence (AAAI-20), New York, USA, 2020: 279–286. doi: 10.1609/aaai.v34i01.5361. [21] SUN Chao, CHEN Min, CHENG Jialiang, et al. SCLAV: Supervised cross-modal contrastive learning for audio-visual coding[C]. 2023 31st ACM International Conference on Multimedia (ACM MM), Ottawa, Canada, 2023: 261–270. doi: 10.1145/3581783.3613805. [22] SUN Chao, CHEN Min, ZHU Chuanbo, et al. Listen with seeing: Cross-modal contrastive learning for audio-visual event localization[J]. IEEE Transactions on Multimedia, 2025, 27: 2650–2665. doi: 10.1109/TMM.2025.3535359. [23] YU Jiashuo, CHENG Ying, ZHAO Ruiwei, et al. MM-pyramid: Multimodal pyramid attentional network for audio-visual event localization and video parsing[C]. 2022 30th ACM International Conference on Multimedia (ACM MM), Lisbon, Portugal, 2022: 6241–6249. doi: 10.1145/3503161.3547869. [24] HE Xiang, LIU Xiangxi, LI Yang, et al. CACE-Net: Co-guidance attention and contrastive enhancement for effective audio-visual event localization[C]. 2024 32nd ACM International Conference on Multimedia (ACM MM), Melbourne, Australia, 2024: 985–993. doi: 10.1145/3664647.3681503. [25] GUZHOV A, RAUE F, HEES J, et al. Audioclip: Extending clip to image, text and audio[C]. 2022 47th IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), Singapore, Singapore, 2022: 976–980. doi: 10.1109/ICASSP43922.2022.9747631. [26] LIN Yanbo, SUNG Y L, LEI Jie, et al. Vision transformers are parameter-efficient audio-visual learners[C]. 2023 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Vancouver, Canada, 2023: 2299–2309. doi: 10.1109/CVPR52729.2023.00228. [27] WANG Kai, TIAN Yapeng, and DIMITRIOS H. Towards efficient audio-visual learners via empowering pre-trained vision transformers with cross-modal adaptation[C]. 2024 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Seattle, USA, 2024: 1837–1846. doi: 10.1109/CVPRW63382.2024.00190. [28] CHENG Ying, LI Yang, HE Junjie, et al. Mixture of experts for audio-visual learning[C]. Proceedings of the 38th International Conference on Neural Information Processing Systems, Vancouver, Canada, 2024: 7. doi: 10.52202/079017-0007. [29] HUANG Longzhuo, LI Liang, FU Xueyang, et al. Efficient prompt-based multimodal interaction for audio-visual event localization[C]. Proceedings of the 2025 International Conference on Multimedia Retrieval, Chicago, USA, 2025: 506–515. doi: 10.1145/3731715.3733320. -

 下载:

图(7) / 表(5)
计量
- 文章访问数: 18
- HTML全文浏览量: 2
- PDF下载量: 0
- 被引次数: 0
